Năm 2023, một nhóm nhà nghiên cứu của Trường Kinh doanh Harvard cùng các đồng nghiệp ở Wharton, MIT và nhiều nơi khác làm một việc hiếm thấy: thử AI trên những người làm nghề thật, với bài toán thật, ở quy mô lớn. Đối tác là Boston Consulting Group. 758 tư vấn viên tham gia, chiếm khoảng 7% lực lượng tư vấn viên cá nhân của hãng1,3.
Nhóm được chia ngẫu nhiên. Một phần làm việc như bình thường. Một phần được dùng GPT-4. Một phần được dùng GPT-4 kèm hướng dẫn ngắn về cách viết câu lệnh. Rồi tất cả nhận cùng những nhiệm vụ mà tư vấn viên vẫn làm hằng ngày: lên ý tưởng sản phẩm, phân tích thị trường, viết đề xuất, trình bày cho khách hàng1.
Bên trong biên giới
Với 18 nhiệm vụ nằm trong khả năng của AI, kết quả rất ấn tượng. Tư vấn viên dùng AI hoàn thành nhiều hơn 12,2% số nhiệm vụ, nhanh hơn 25,1%, và chất lượng được chấm cao hơn trên 40% so với nhóm đối chứng1.
Người hưởng lợi nhiều nhất lại là người vốn yếu hơn. Những người dưới mức trung bình tăng 43% điểm so với chính họ khi không dùng AI. Những người trên trung bình tăng 17%1. AI thu hẹp khoảng cách giữa người giỏi và người chưa giỏi.
Nếu dừng ở đây, đây sẽ là một nghiên cứu để trình chiếu trong mọi buổi giới thiệu công cụ AI.
Bên ngoài biên giới
Nhưng các nhà nghiên cứu cố ý thiết kế thêm một nhiệm vụ nằm ngoài khả năng của AI. Nhiệm vụ này nhìn qua không khó hơn những nhiệm vụ kia. Nó đòi hỏi kết hợp số liệu định lượng với những chi tiết tinh tế trong các cuộc phỏng vấn, loại việc mà mô hình khi ấy thường trả lời sai một cách rất tự tin.
Ở nhiệm vụ này, tư vấn viên dùng AI có khả năng đưa ra đáp án đúng thấp hơn 19 điểm phần trăm so với người không dùng1. Họ tin vào câu trả lời trôi chảy của máy, và bỏ qua phán đoán của chính mình.
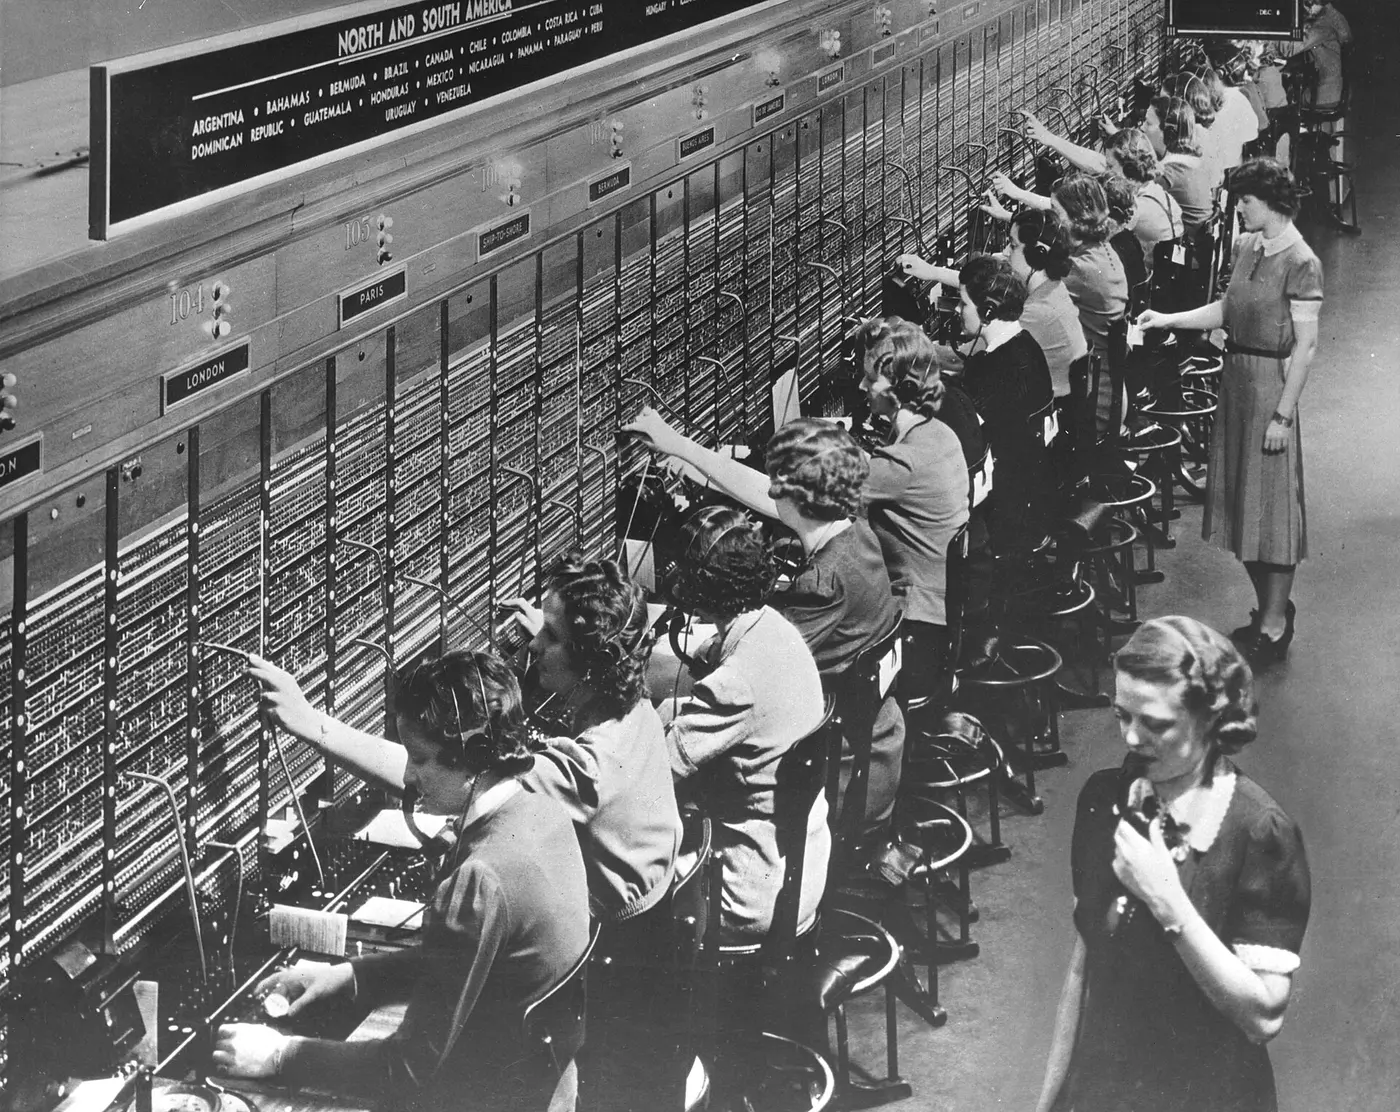
Các tác giả gọi hiện tượng này là "biên giới công nghệ lởm chởm": AI giỏi xuất sắc ở một số việc và tệ bất ngờ ở những việc khác có độ khó tương đương, và đường ranh giữa hai vùng ấy không nhìn thấy bằng mắt thường1.
Hai kiểu người làm việc cùng máy
Khi quan sát cách những người làm tốt dùng AI, nhóm nghiên cứu thấy hai kiểu. Kiểu thứ nhất, họ gọi là nhân mã, chia việc rõ ràng: phần nào giao cho máy, phần nào tự làm, và kiểm tra kết quả của máy trước khi dùng. Kiểu thứ hai, họ gọi là người máy, đan xen liên tục với AI trong từng bước, thử, sửa, hỏi lại1.
Điểm chung của cả hai là họ không giao phó phán đoán cho máy. Họ biết, hoặc cố gắng tìm hiểu, đâu là vùng AI làm tốt và đâu là vùng cần nghi ngờ.
Vì sao đây là việc của bộ phận đào tạo
Nhiều doanh nghiệp đã mua tài khoản AI cho toàn bộ nhân viên và coi như xong phần chuyển đổi. Thí nghiệm của BCG cho thấy cấp tài khoản chỉ là bước đầu tiên, và có thể gây hại nếu dừng ở đó: ở những việc nằm ngoài biên giới, người có AI làm kém hơn người không có.
Năng lực cần dạy không phải là cách viết câu lệnh cho hay. Nó là khả năng nhận ra việc nào nằm trong vùng AI làm tốt, việc nào không, và thói quen kiểm tra trước khi tin. Năng lực ấy khác nhau theo từng nghề, từng quy trình, nên không có khóa học chung nào dạy thay được.
Biên giới ấy trong nghề nhân sự
Nghiên cứu làm với tư vấn viên, nhưng câu hỏi áp dụng cho mọi nghề văn phòng, kể cả nhân sự. Một số việc thường nằm gọn trong vùng AI làm tốt: soạn bản nháp mô tả công việc, tóm tắt hàng trăm bình luận trong khảo sát gắn kết, gợi ý câu hỏi phỏng vấn theo năng lực, viết lại một thông báo cho dễ hiểu.
Một số việc khác trông không khó hơn nhưng lại dễ trượt ra ngoài biên giới: tính lương làm thêm giờ, thuế thu nhập cá nhân hay bảo hiểm theo quy định Việt Nam vừa thay đổi, diễn giải một điều khoản của Bộ luật Lao động cho một tình huống cụ thể, cân nhắc hình thức kỷ luật cho một vụ việc nhiều tình tiết. Ở những việc này, câu trả lời của máy thường trôi chảy và tự tin, và chính sự tự tin ấy làm người dùng bỏ qua bước kiểm tra.
Danh sách trên không cố định. Mỗi phiên bản mô hình mới lại đẩy biên giới đi một đoạn, theo những hướng không ai đoán trước được. Kết quả của nhóm Harvard sau đó đã được bình duyệt và đăng trên tạp chí Organization Science2, nhưng bài học quan trọng nhất của nó không phụ thuộc vào mô hình nào: đừng giả định, hãy thử trên chính công việc của mình.